Escolher o modelo de IA (LLM) — GPT-4, Claude e Gemini no Chatys
O Chatys é compatível com os principais modelos de linguagem do mercado — da Anthropic (Claude), da OpenAI (GPT) e do Google (Gemini). Cada modelo tem características diferentes de qualidade, velocidade e custo. Escolher o modelo certo para o seu caso de uso faz uma diferença real tanto na experiência dos seus clientes quanto no custo mensal da operação de IA.
Neste artigo você vai entender as diferenças entre os modelos disponíveis, comparar custo e desempenho para atendimento em português brasileiro, e aprender como configurar e trocar o modelo a qualquer momento no Chatys.
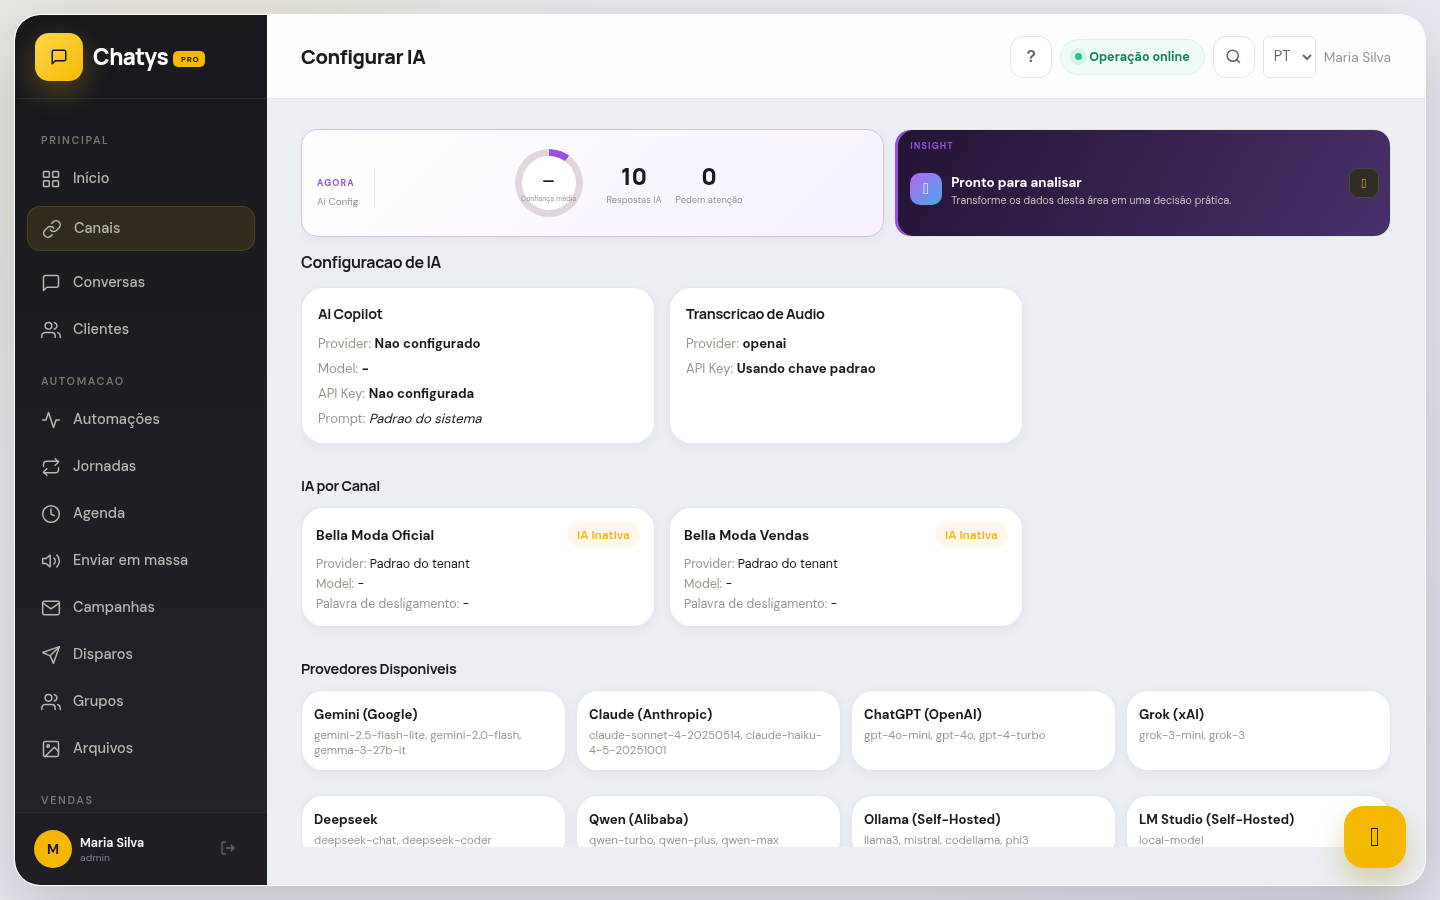
Configurações do Agente IA — selecione o modelo de IA, ajuste temperatura e configure as chaves de API na tela de Configurar IA
Modelos disponíveis no Chatys
O Chatys suporta os seguintes modelos de linguagem em 2025:
Melhor qualidade geral. Respostas precisas, empáticas e naturais em português BR. Contexto longo (200K tokens).
Mais rápido e econômico. Ótimo para triagem e alto volume de mensagens simples.
Excelente em múltiplos idiomas e tarefas complexas. Raciocínio robusto e versátil.
Excelente para multimodal (imagens + texto). Contexto muito longo (1M tokens). Bom custo-benefício.
Comparativo: GPT-4o vs Claude 3 vs Gemini
| Modelo | Qualidade PT-BR | Velocidade | Custo relativo | Contexto |
|---|---|---|---|---|
| Claude 3 Sonnet | Excelente | Alta | Médio | 200K tokens |
| Claude 3 Haiku | Muito bom | Muito alta | Baixo | 200K tokens |
| GPT-4o | Bom | Alta | Médio-Alto | 128K tokens |
| Gemini 1.5 Pro | Bom | Alta | Baixo-Médio | 1M tokens |
Observações importantes sobre o comparativo:
- Qualidade PT-BR: Claude 3 Sonnet tem o português mais natural e empático, especialmente em situações de atendimento ao cliente. GPT-4o e Gemini são mais orientados para inglês mas têm desempenho sólido em português.
- Contexto: O Gemini 1.5 Pro tem janela de contexto de 1 milhão de tokens — muito útil para conversas muito longas ou para processar documentos extensos na KB.
- Custo: Os valores variam com o câmbio e as políticas de precificação dos fornecedores. O Chatys consolida o custo de IA no faturamento mensal, então você não precisa pagar diretamente aos fornecedores.
Custo por tokens e impacto no faturamento
Os modelos de IA cobram por tokens — unidades de texto processado. Aproximadamente 1.000 tokens equivalem a 750 palavras ou 4.000 caracteres. Cada conversa consome tokens tanto na entrada (mensagem do cliente + contexto da KB + system prompt) quanto na saída (resposta do agente).
Referência de custos aproximados em 2025 (sujeitos a variação):
- Claude 3 Sonnet: ~US$0,003/1K tokens de entrada + ~US$0,015/1K tokens de saída
- Claude 3 Haiku: ~US$0,00025/1K tokens de entrada + ~US$0,00125/1K tokens de saída
- GPT-4o: ~US$0,005/1K tokens de entrada + ~US$0,015/1K tokens de saída
- Gemini 1.5 Pro: ~US$0,0035/1K tokens de entrada + ~US$0,0105/1K tokens de saída
Exemplo prático: uma conversa típica de atendimento ao cliente (10 mensagens com KB) consome cerca de 2.000 a 4.000 tokens totais. Com Claude 3 Haiku, isso custa menos de US$0,01 por conversa. Com Claude 3 Sonnet, aproximadamente US$0,06 por conversa.
Qual modelo escolher para o seu caso de uso
A escolha do modelo ideal depende do seu perfil de negócio, volume de mensagens e prioridade (qualidade vs custo):
Recomendado: Claude 3 Sonnet. Melhor qualidade em português, empatia e seguimento de instruções. O custo ligeiramente maior se paga em menos transferências para humano e melhor CSAT.
Recomendado: Claude 3 Haiku. Excelente para responder perguntas diretas como horários, preços, localização e status de pedido. Custo até 20x menor que o Sonnet com qualidade adequada para FAQ.
Recomendado: Gemini 1.5 Pro. Se você atende clientes em inglês, espanhol e português, ou se recebe imagens de produtos e precisa analisá-las no atendimento, o Gemini é a melhor opção.
Recomendado: GPT-4o. Melhor para casos que envolvem raciocínio em múltiplas etapas, comparação de opções ou integração com dados externos via API.
Configurando o modelo no Chatys
sk-ant-. Chaves OpenAI começam com sk-. Dê um nome descritivo à chave (ex: "Claude — Produção") e clique em "Verificar e salvar".Ajustando temperatura e criatividade
A temperatura é um parâmetro que controla o grau de "criatividade" ou "previsibilidade" das respostas do modelo. É um dos ajustes mais impactantes para calibrar o comportamento do agente:
- Temperatura 0 a 0.2 (muito conservador): Respostas altamente determinísticas e previsíveis. O modelo sempre escolhe as palavras mais prováveis. Ideal para FAQ estrito onde cada resposta deve ser sempre a mesma. Pode soar repetitivo se usado no atendimento geral.
- Temperatura 0.3 a 0.6 (balanceado): Bom equilíbrio entre consistência e naturalidade. Recomendado para a maioria dos casos de atendimento ao cliente — respostas variadas o suficiente para não soar robotizado, mas previsíveis o suficiente para seguir as instruções.
- Temperatura 0.7 a 1.0 (criativo): Respostas mais variadas e criativas. Útil para contextos de marketing, geração de conteúdo ou quando você quer que o agente seja mais conversacional e menos formulaico. Não recomendado para FAQ estrito — pode gerar variações inesperadas.
Para ajustar a temperatura:
Casos de uso — como aplicar no seu negócio
Veja como empresas de diferentes segmentos utilizam esta funcionalidade na prática:
🛍️ E-commerce e lojas online
Um e-commerce de alto volume usa Claude Haiku para responder FAQs simples de forma ultrarrápida e barata (100ms de resposta, custo mínimo por mensagem). Para análise de reclamações complexas, usa GPT-4o. Essa arquitetura híbrida otimiza o custo total sem sacrificar qualidade nas situações que realmente importam.
🏥 Clínicas e profissionais de saúde
Clínicas com laudos médicos optam pelo Claude 3 Sonnet — superior para textos longos e análise de contexto médico. A janela de contexto de 200K tokens permite processar protocolos médicos completos sem truncamento. Aqui, precisão é mais importante que velocidade, e o modelo reflete essa prioridade.
🏠 Imobiliárias e construtoras
Uma agência de marketing que gerencia múltiplas marcas imobiliárias usa modelos diferentes por cliente: a marca premium usa GPT-4o (respostas mais criativas e sofisticadas), enquanto as marcas populares usam Haiku (velocidade e custo). A configuração é feita por workspace, sem interferência entre contas.
🍕 Restaurantes e food service
E-commerces com operações em múltiplos idiomas (exportação para América Latina, EUA ou Europa) escolhem GPT-4o para atender clientes em inglês, espanhol e português com a mesma qualidade. O modelo multilíngue elimina "sotaque" de tradução e erros gramaticais que prejudicam a experiência do cliente estrangeiro.
💼 Serviços, consultoria e SaaS
Startups com orçamento restrito começam com Claude Haiku (mais barato) para o volume todo. Conforme a receita cresce e o perfil das perguntas fica mais complexo, migram gradualmente para Sonnet. Essa escalabilidade financeira permite crescer o atendimento sem comprometer o caixa no início da operação.
- Comece com Claude Sonnet — melhor custo-benefício para a maioria dos casos de atendimento ao cliente em português.
- Migre para GPT-4o apenas se precisar de criatividade especial, multilíngue avançado ou funcionalidades específicas como visão computacional.
- Monitore o custo de tokens mensalmente e ajuste o modelo se ultrapassar o orçamento — o painel de Insights IA mostra o consumo detalhado por agente.
Problemas comuns
- Custo de IA acima do esperado no faturamento: Verifique no Insights IA o consumo de tokens por agente e por período. As principais causas de alto consumo são: Knowledge Base muito grande (muitos trechos enviados como contexto), System Prompt muito longo, conversas longas sem resolução (muitas trocas de mensagem). Soluções: otimize a KB removendo conteúdo redundante, encurte o System Prompt sem perder informação essencial, e configure o handoff para evitar conversas muito longas com a IA.
- Respostas muito repetitivas e mecânicas: Temperatura está muito baixa. Aumente para 0.5 a 0.7 e teste novamente. Também verifique se o System Prompt não está com instruções muito restritivas que limitam demais a variação das respostas.
- Modelo selecionado mas aparece como "Indisponível": A chave de API do provedor correspondente não está configurada ou está inválida. Acesse Configurações → Integrações → APIs de IA, verifique se a chave está lá e clique em "Testar" para validar. Se a chave expirou ou foi revogada no provedor, gere uma nova e atualize no Chatys.
- IA demora muito para responder (alta latência): Todos os modelos têm latência, mas acima de 10 segundos para a primeira palavra é incomum. Possíveis causas: KB muito grande enviando muitos tokens de contexto, System Prompt excessivamente longo, ou problema de conectividade com a API do provedor. Tente trocar temporariamente para Claude 3 Haiku (mais rápido) para verificar se é problema do modelo específico ou da infraestrutura.
Este artigo foi útil?